 ChatGPT
 Perplexity
 Claude
 Gemini
一句话总结
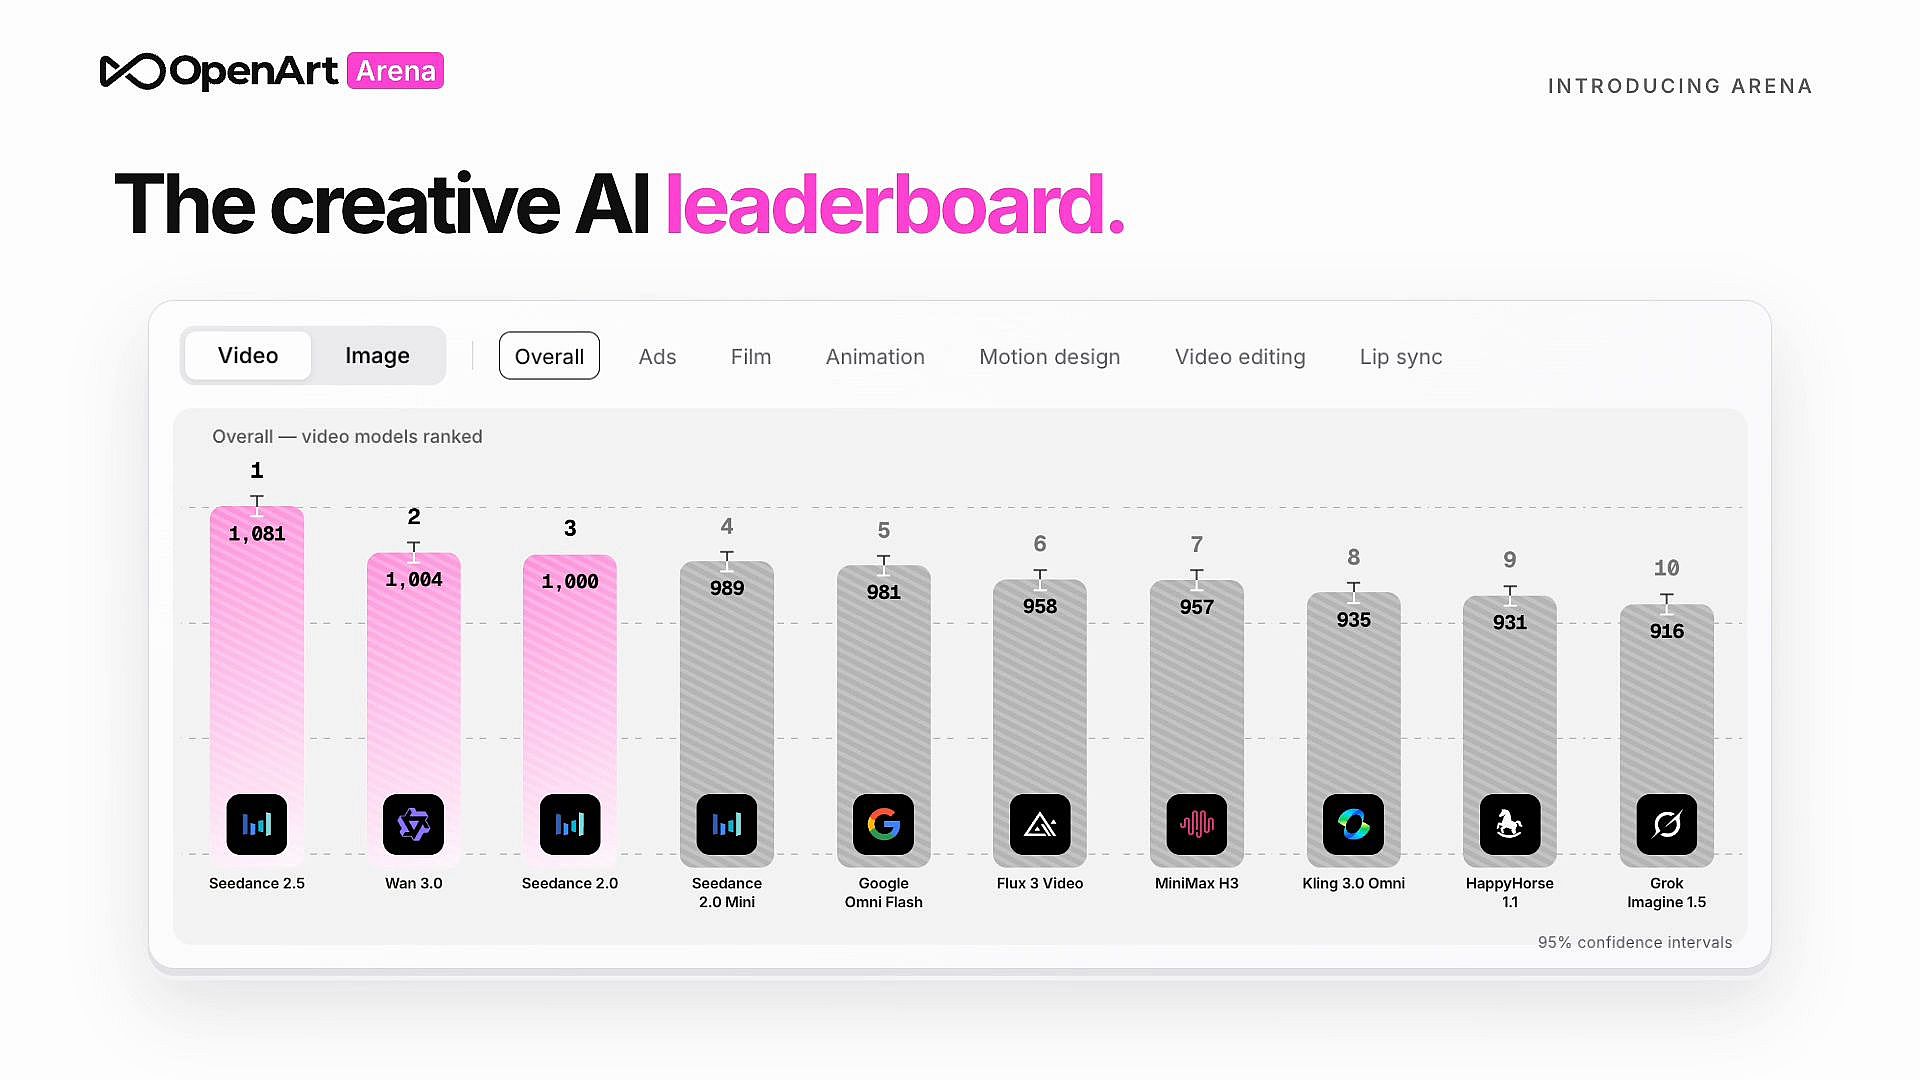
- OpenArt Arena 现已上线。 AI 图像与视频模型排行榜 让你在广告、电影、动画、产品图、平面设计、编辑和对口型等方面比较不同模型。
- 发布结果基于 28 位专家评委和 1,003 位品味达人的盲测评估。
- 每个榜单专注于不同的任务,因此你可以按项目所需的能力去挑选,而不必只依赖一个综合排名。
一张产品图看起来很棒,直到你发现标签变了。一段生成的电影场景灯光很美,但镜头运动方向却错了。正是这些细节决定了一个 AI 成果能否进入最终成片。
OpenArt Arena 现已上线,帮助创作者在考量这些细节的前提下比较模型。你可以浏览 AI 图像与视频模型排名,查看各项标准上的表现,并在决定尝试哪个模型前先看看示例生成效果。
Arena 背后的问题很简单:哪个模型最适合你要做的工作?
从任务出发的排行榜
假设你正在为一款新护肤品做宣传活动。你需要产品页的静态图、一段短视频广告,以及一位为社交媒体讲话的主持人。这些素材同属一个活动,但它们对模型的要求各不相同。
对于产品图,瓶身、标签和颜色都需要保持准确。对于广告,产品在动态中必须看起来令人信服。对于出镜主持人,口型需要与音频对上。在其中一项任务上表现出色,对其他任务的参考价值是有限的。
OpenArt Arena 正是围绕这些差异来组织排名。当你想做广泛比较时,有综合图像和视频榜单;当你已经明确需求时,还有行业和能力榜单。
这正是 OpenArt 所秉持的理念 创意 AI 模型排名:让比较足够具体,以便真正帮助你做出制作决策。
你现在可以比较的内容
排行榜有两个主要视图:视频和图像。先选一个,再选择与你工作相符的榜单。
视频模型排行榜
- 综合: 跨各类用例的通用视频能力。
- 广告: 商业与品牌视频。
- 电影: 电影感场景与叙事。
- 动画: 动画角色与镜头序列。
- 动态设计: 以设计为主导的动态作品。
- 视频编辑: 对现有视频进行修改。
- 口型同步: 让语音或歌声与可见的口型动作相匹配。
图像模型排行榜
- 综合: 跨各类用例的通用图像能力。
- 产品/电商: 以产品为核心的画面。
- 电影: 面向电影的静态影像。
- 平面设计: 视觉传达与设计。
- 图像编辑: 对现有图像进行修改。
影视会出现在两个视图中,因为生成静帧和生成动态序列是不同的任务。同样,图像编辑也有专属榜单:能生成一张新图,并不一定意味着模型能对现有图像做出精准的修改。
在广告中重要的东西,在电影中未必重要
一个变形的 logo 可能让原本精致的广告变得无法使用。在电影场景中,角色面部或灯光的意外变化会破坏连贯性。在平面设计中,一处拼错的标题或排版糟糕的文字就可能毁掉整个作品。
Arena 的 AI 模型评判标准 正体现了这些差异。广告类评估会考量产品和品牌一致性;影视类评估会考量镜头和光影控制;平面设计类评估则关注排版和字体等细节。
这让你有理由不只看综合排行榜的第一行。如果你的简报依赖准确的文字,就查看相关标准。如果你需要模型在不改动其他部分的情况下完成编辑,就从编辑榜单入手。
你最终可能会为同一项目的不同环节选择不同的模型。这是一个有价值的结果:目的就是找到最契合工作的工具。
谁来评判成果,又是如何评判的?
根据 2026 年 9 月 15 日的更新,已发布的发布结果纳入了 28 位专家评委和 1,003 位品味达人的贡献。 AI 模型评审团 汇聚了来自电影、广告、学术界和创作者经济领域的从业者,以及来自制片厂、学校和创意社区的实践者。
评判者在不知道结果由哪个模型生成的情况下比较两份输出。每次比较都针对一个指定的标准,而不是简单地问他们更喜欢哪个结果。模型接收相同的简报,而提交评测的输出是按固定规则选出的,而非人工挑选。
投票通过 Bradley–Terry 模型来计算相对得分。专家委员会的投票权重是品味达人投票的三倍。已发布的 AI 模型排名方法论 更详细地说明了评分、权重和核查机制。
结果包含 95% 置信区间。当这些区间重叠时,微小的分数差异不应被视为明显优势。分数也只属于各自的榜单:电影榜和广告榜上的同一个数字并不代表相同的性能水平。
发布时收录了哪些模型?
已发布的发布阵容包含七个图像模型和十一个视频模型。各榜单的模型列表可能更少,具体取决于资格和评估覆盖范围。
图像模型: Seedream 5.0 Pro、GPT Image 2、Nano Banana Pro、Grok Imagine 2.0、Nano Banana 2、Qwen Image 3.0 和 Flux.2 Pro。
视频模型: Seedance 2.5、Wan 3.0、Seedance 2.0、Seedance 2.0 Mini、Google Omni Flash、Flux 3 Video、MiniMax H3、Kling 3.0 Omni、HappyHorse 1.1、Grok Imagine 1.5 和 PixVerse V6。
这些名称指的是发布时的结果,而非固定的名单。请查看实时榜单以获取最新公布的覆盖范围,并在比较结果时留意模型版本。
从排名到可用的模型
找到相关榜单后,看看哪些标准可能决定你交付成果的成败。然后查看示例 prompt 和生成结果。当你能看到分数背后的实际输出时,分数就更容易理解了。
在最终决定之前,用同一份简报和同一套参考素材试用几个入围的模型。做产品宣传时,用你实际的包装。做角色场景时,用你打算使用的参考图。这样你才能发现榜单中体现的优势是否真能延续到你的项目中。
也别忘了查看制作要求。分辨率、支持的参考素材、视频时长、生成时间和价格都可能影响你的选择。这些规格与 Arena 的质量评分是相互独立的。
Arena 可以帮你决定从哪里开始测试。而你自己的简报才决定哪个模型能在工作流程中占有一席之地。
Arena 与其他 AI 排行榜的定位差异
Arena.ai、Artificial Analysis 以及托管在 Hugging Face 上的排行榜项目提供了其他比较模型的方式,包括偏好排名、技术评测以及价格或速度对比。
OpenArt Arena 专注于创意生产,采用专家主导的评判,并为特定行业和任务设立榜单。在跨平台比较结果时,请注意每项评估衡量的内容、涵盖的模型版本以及评判者是谁。不同的评估可能得出不同的排名,因为它们回答的并非同一个问题。
OpenArt 运营 Arena,并评测其平台上可用的模型。其 AI 模型基准测试披露 阐明范围、商业合作关系、评委报酬及数据处理方式。OpenArt 声明,没有任何模型提供方为入选、排位、排名或优待付费。
常见问题
我在哪里能看到当前排名第一的模型?
打开排行榜,选择图像或视频,再选定一个榜单。排名第一的模型可能因任务而异,因此在查看总排名的同时,请留意相关评判标准和置信区间。
Arena 是否涵盖了所有 AI 图像和视频模型?
不是。Arena 评测的是 OpenArt 上一组特定的模型。所选榜单会显示该次比较中包含哪些模型。
我能参与模型评测吗?
可以,你可以申请成为品味达人。请访问 创意 AI 评判者与品味领袖页面 并按照申请链接操作。
我该如何反馈某个结果的问题?
邮箱 arena@openart.ai ,并注明你所指的榜单、模型版本和结果。
选好模型后,我在哪里生成图像和视频?
使用 OpenArt,用你自己的 prompt 和参考素材测试你入围的模型,然后就在那里继续创作。