 ChatGPT
 Perplexity
 Claude
 Gemini
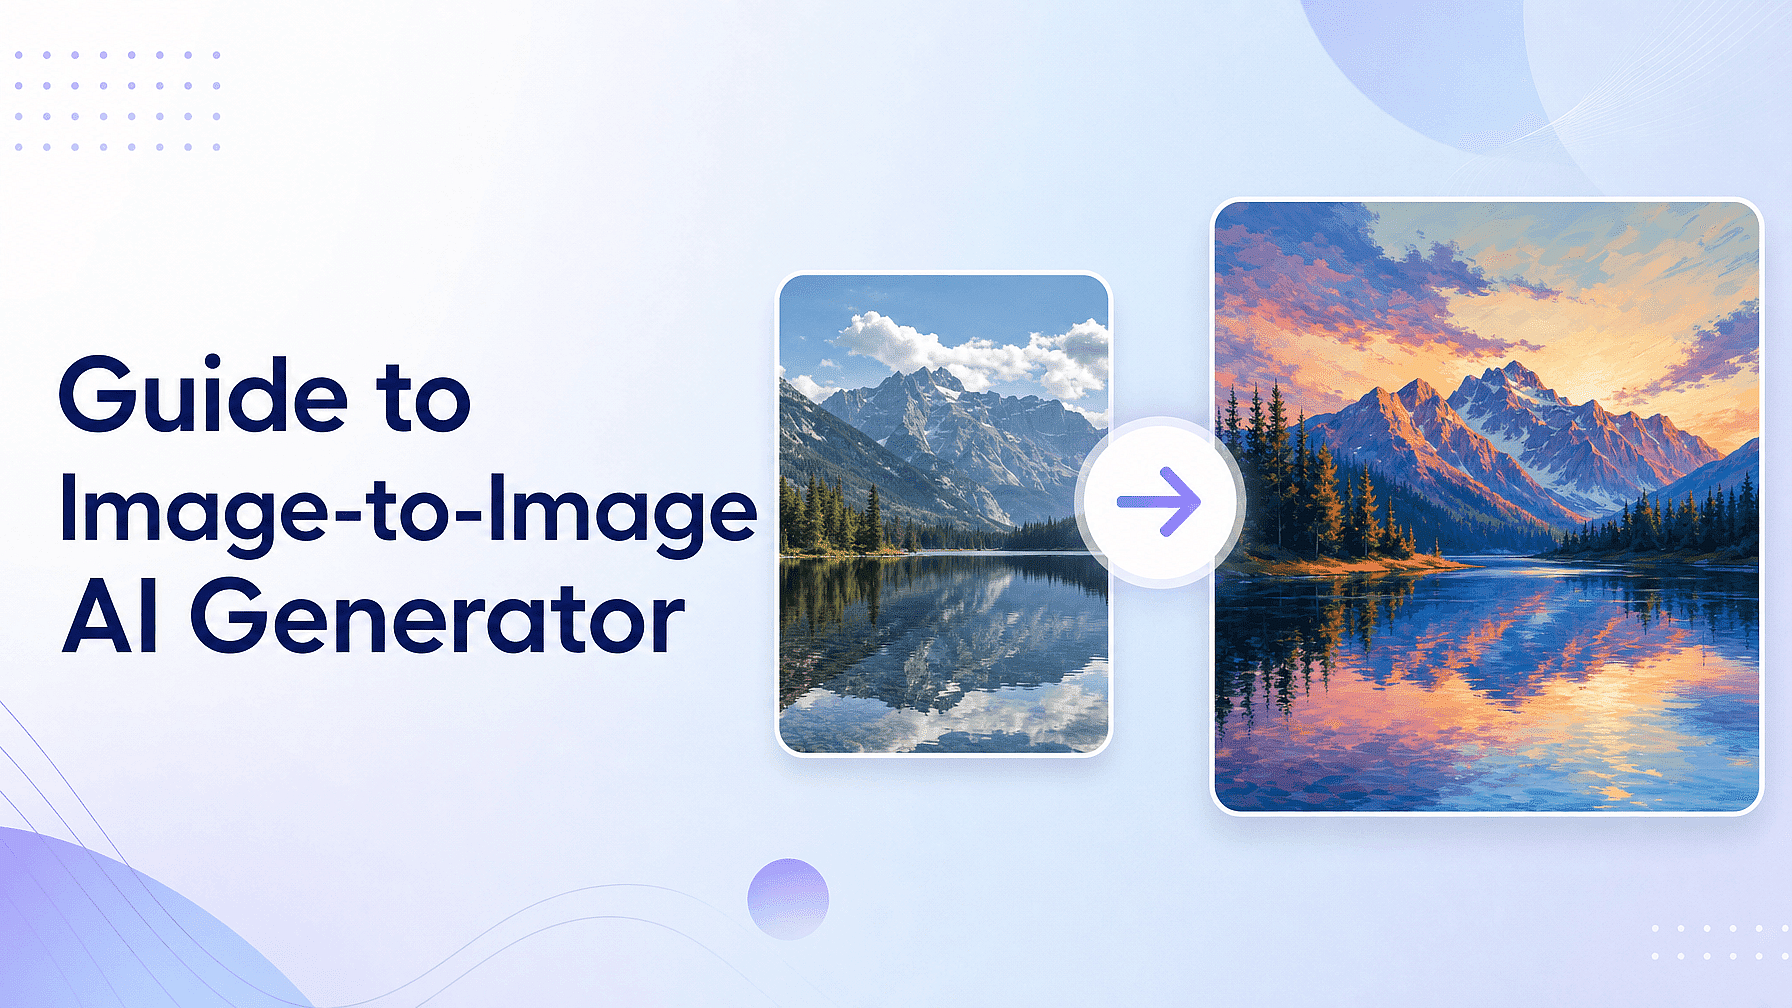
Importe une photo, ajoute un prompt, et le modèle crée une nouvelle image qui conserve la composition, la pose, l'éclairage ou le style de ta référence tout en changeant ce que tu as demandé.
C'est la génération image-vers-image, et elle résout le problème que les prompts textuels ne peuvent pas résoudre. Le texte seul ne peut pas reproduire quelque chose qui existe déjà, que ce soit ton produit, ton personnage, ta mise en page ou un style que tu as passé des années à peaufiner.
Points clés à retenir
- L'image-vers-image reprend la structure et le style de ta référence au lieu de copier ses pixels. La composition et la pose se transposent de manière fiable. Les détails fins, non.
- Les logos précis et les petits textes sont le point faible, alors prévois des retouches masquées et une vérification humaine plutôt que de te fier à un prompt.
- Chaque modèle excelle sur des tâches différentes, c'est pourquoi faire passer une même référence par deux ou trois modèles vaut mieux que de s'en tenir à un seul.
- Les éditeurs plus récents ont supprimé le curseur de fidélité, donc la préservation passe désormais dans le prompt sous forme d'instruction explicite.
- Importer une référence sur laquelle tu n'as pas de droits est un risque en soi, indépendamment du rendu final.
Qu'est-ce qu'un générateur d'images IA à partir d'une image ?
Un générateur d'images IA à partir d'image, souvent appelé image-vers-image ou img2img, prend deux entrées au lieu d'une : une image de référence et un prompt textuel. Le modèle lit la couleur, la structure, l'éclairage et la pose de la référence au lieu d'en copier les pixels. Puis il construit une nouvelle image, guidée par ton prompt.
Si tu n'as utilisé que le texte-vers-image, la différence saute aux yeux dès qu'il s'agit de contrôle. Un prompt textuel peut décrire « une femme en veste rouge, vue de trois quarts », mais il ne peut pas reproduire une femme précise, une veste précise ou un angle de caméra précis.
Une image de référence, oui. Sur OpenArt, tu télécharges la photo avec ton prompt pour que le rendu conserve ta composition tout en changeant le style, l'ambiance ou les détails.
Image vers image versus texte vers image
Les deux approches reposent sur les mêmes modèles sous-jacents. Elles résolvent des problèmes différents.
| Dimension | Image vers image | Texte vers image |
|---|---|---|
| Entrée | Image de référence plus un prompt texte | Prompt texte uniquement |
| Contrôle | Élevée, car la composition et la pose sont ancrées sur la référence | Plus bas, puisque le modèle construit à partir de ta description |
| Cohérence | Le même sujet ou la même mise en page sur de nombreuses générations | Chaque génération repart de zéro |
| Idéal pour | Photos de produits, transfert de style, travail sur les personnages, restylisation de photos | Conception, exploration, scènes inédites |
Utilise le text-to-image quand tu explores encore et que tu ne sais pas ce que tu veux. Utilise l'image-to-image une fois que tu as déjà l'élément — comme une photo produit, une fiche de personnage, un croquis ou une mise en page — et qu'il te faut des versions qui lui restent fidèles.
Comment fonctionne l'IA image-to-image
Les modèles de diffusion gèrent ça en encodant ta référence sous une forme compressée, en ajoutant une quantité de bruit contrôlée, puis en utilisant ton prompt pour guider le nettoyage. La doc de Hugging Face le dit clairement. Une valeur de force plus élevée donne au modèle plus de liberté pour créer quelque chose de différent de ta référence. À une force de 1,0, la référence est « plus ou moins ignorée ».
Le modèle extrait la structure et le style de ta référence. Il reprend fidèlement la composition, la palette de couleurs, la direction de la lumière, la pose et l'angle de caméra. Ce qu'il ne reprend pas de façon fiable, ce sont les détails fins précis.
Photoroom a testé 850 produits de vêtements et d'accessoires sur 3 400 générations en juillet 2026. Le meilleur modèle a passé ses contrôles de précision produit dans 29,0 % des générations. La distorsion des logos ou du texte était l'échec le plus courant, à 20,1 %. Photoroom vend une couche de fidélité produit, il a donc un intérêt dans cette réponse.
La leçon reste valable, même en tenant compte de la source. Si ton travail dépend d'une étiquette ou d'un logo exact, prévois des retouches masquées et une vérification humaine, pas seulement des prompts.
Transfert de style depuis une image de référence
Le transfert de style fonctionne parce que le modèle lit le look d'une référence indépendamment de son contenu. La documentation de Midjourney le résume bien. Une référence de style « capture l'ambiance visuelle d'une image existante », c'est-à-dire ses couleurs, son medium, ses textures ou son éclairage. Elle « ne copie pas les objets ni les personnes ».
La même idée s'applique à tous les outils. Ta référence fournit le style et ton prompt fournit le sujet.
Pour conserver un même rendu sur toute une série, enregistre-le au lieu de le réimporter à chaque fois. Le Brand Kit d'OpenArt stocke tes couleurs, polices et références de style au niveau du projet, et OpenArt Characters enregistre une personne que tu peux taguer dans tes images ultérieures.
Maîtriser la fidélité du rendu
Les outils Stable Diffusion disposent d'un curseur de force ou de débruitage qui règle directement l'équilibre. Le calcul est simple : multiplie la force par le nombre d'étapes d'inférence pour obtenir les étapes réellement exécutées, donc une force de 0,8 avec 50 étapes exécute 40 étapes de changement.
En clair, un réglage plus bas garde le résultat proche de la photo que tu as importée et un réglage plus élevé laisse plus de liberté au modèle. L'échelle de Stable Diffusion Art donne un bon repère approximatif : environ 0,2 donne un léger changement, 0,6 un grand changement et 1,0 un très grand changement. Considère les chiffres plus précis que tu vois en ligne comme des valeurs par défaut testées par quelqu'un plutôt que comme des recommandations officielles, et trouve les tiennes.
OpenArt gère ça avec un curseur de créativité sur l'image-vers-image, allant d'un léger restylage qui reste proche de l'original à une réinterprétation audacieuse qui ne conserve que la composition générale.
Midjourney utilise le poids d'image, noté --iw, à la place. Sa doc indique une plage de 0 à 3 avec une valeur par défaut de 1 sur la V8.1, et aucune valeur publiée pour la V8.2 pour l'instant.
Les éditeurs plus récents basés sur les instructions, comme FLUX.1 Kontext et GPT Image 2, ont carrément supprimé le curseur. Tu contrôles la fidélité en intégrant des clauses de préservation dans le prompt.
Comment générer une image à partir d'une référence, étape par étape
Le processus est à peu près le même partout. Le voici sur OpenArt.
- Importe ton image de référence dans le Générateur d'images IA.
- Écris ton prompt. Décris l'image finale que tu veux, pas des instructions pour éditer la référence.
- Choisis un modèle. GPT Image 2 gère les instructions complexes et les petits textes, Nano Banana Pro convient au travail photoréaliste avec plusieurs références, et Seedream 4.5 est le choix idéal pour l'anime et l'illustration à plat.
- Règle le curseur de créativité. Plus bas, tu restes proche de la référence ; plus haut, tu laisses au modèle plus de liberté pour réinterpréter.
- Génère, compare jusqu'à 8 variations et télécharge celles que tu veux.
La vitesse dépend du modèle. FLUX.1 Kontext crée une image de 1024 par 1024 en trois à cinq secondes. Nano Banana tourne en moyenne autour de dix secondes selon les mesures de Replicate. OpenAI indique que les prompts GPT Image 2 complexes peuvent prendre jusqu'à deux minutes.
Meilleurs modèles IA pour l'image-vers-image
Aucun modèle ne l'emporte sur toutes les tâches, d'où l'intérêt concret de faire passer une même référence par plusieurs. Parmi les modèles ci-dessous, GPT Image 2, Nano Banana Pro et Seedream puisent dans le pool de crédits partagé d'OpenArt, donc comparer ces trois-là ne revient pas à comparer des abonnements. FLUX, Stable Diffusion et Midjourney nécessitent chacun leur propre compte.
- FLUX (Black Forest Labs). Sur le propre KontextBench de BFL, FLUX.1 Kontext a obtenu les meilleurs scores en édition de texte et en préservation des personnages. C'était le premier modèle conçu pour les modifications multi-tours qui conservent l'identité au fil des changements. BFL est transparent sur cette limite et documente une dégradation visible après six modifications consécutives. La marque oriente désormais les nouveaux projets vers FLUX.2, qui accepte jusqu'à 8 images de référence via l'API.
- GPT Image 2 (OpenAI). Accepte jusqu'à 16 images en entrée par requête d'édition et traite chaque entrée en haute fidélité. Il se place troisième avec 1 256 Elo sur le classement d'édition d'images d'Artificial Analysis. Sur le benchmark académique GEditBench v2, GPT Image 1.5 a obtenu le meilleur score de suivi d'instructions avec 1 260, et Nano Banana Pro a pris la première place au général.
- Nano Banana Pro (Google). Officiellement Gemini 3 Pro Image. Google documente jusqu'à 14 entrées de référence dans un seul prompt, dont 6 peuvent être en haute fidélité, et une ressemblance cohérente pour jusqu'à cinq personnes. Il génère en 4K natif.
- Seedream (ByteDance). Le choix idéal pour l'anime, l'illustration et les affiches. Seedream 5.0 Pro combine jusqu'à 10 images de référence, et Seedream 4.5 offre un rendu d'animation 2D plus abouti.
- Stable Diffusion. Toujours le plus de contrôle manuel si tu le fais tourner toi-même, avec un curseur d'intensité et des guides structurels ControlNet, même si les ControlNets officiels de SD 3.5 ne couvrent que Canny, Depth et Blur, et que les guides de pose ou de croquis viennent de la communauté.
- Midjourney (V8.2). Une esthétique par défaut soignée grâce aux prompts d'image et aux références de style. Sa fonctionnalité Omni Reference tourne encore sur V7, coûte deux fois plus de temps GPU et ne fonctionne pas avec Vary Region, Pan, Zoom Out, Fast Mode ou Draft Mode. Il n'y a pas de version gratuite, et les forfaits démarrent à 10 $ par mois.
Replicate a mené sa propre comparaison en septembre 2025, sur une génération plus ancienne de modèles. Il a constaté que FLUX.1 Kontext et Nano Banana préservaient le mieux la typographie et la texture dans les édits de texte, et que Nano Banana et Seedream surpassaient Kontext sur le transfert de style. Teste ta propre référence avant de dépenser des crédits sur un lot.
Principaux cas d'usage
L'image-vers-image trouve sa place partout où le résultat doit correspondre à quelque chose qui existe déjà.
- Transfert de style. Applique un style pictural, un rendu cinéma ou une esthétique de marque à une photo que tu as déjà.
- Photographie de produit. Transforme une photo prise au téléphone en un shot éclairé comme en studio sur une nouvelle surface, en préservant la forme du produit.
- Conversion en anime et en illustration. Transforme des portraits en styles anime, illustration ou BD tout en conservant l'identité et la pose.
- Cohérence des personnages. Garde le même visage, la même tenue et les mêmes proportions sur des dizaines de générations.
- Fusion des références. Fusionne plusieurs entrées en une seule sortie, avec Nano Banana Pro qui en accepte jusqu'à 14 et FLUX.2 jusqu'à 8.
- Image vers vidéo. Utilise une image finalisée comme première image d'un clip.
Cohérence des personnages entre les résultats
La dérive d'identité est le principal problème du travail basé sur une référence. Le même visage revient subtilement différent à chaque génération, et à la dixième image le personnage est devenu discrètement quelqu'un d'autre.
Personnages OpenArt gère la dérive en faisant du personnage un asset enregistré plutôt qu'une référence propre à chaque prompt. Crée le personnage une seule fois à partir d'un prompt, d'une photo de référence ou d'un préréglage. Ensuite, tague ce même personnage dans n'importe quelle image ou vidéo ultérieure, y compris des scènes dans OpenArt Director, l'outil vidéo multi-scènes.
Cette différence compte plus que n'importe quel score de benchmark. Une image de référence oblige le modèle à recalculer le visage à chaque fois, alors qu'un personnage enregistré lui donne le même point de départ à chaque fois.
Prompt engineering pour l'image-vers-image
Chaque éditeur actuel comprend le langage naturel plutôt que des mots-clés. Les mêmes règles valent pour FLUX, GPT Image et Gemini. Décris l'image finale que tu veux, pas les modifications à apporter.
Indique clairement ce qui doit être préservé et choisis des verbes précis. Black Forest Labs le dit sans détour dans son guide de prompt : « transform » implique un changement complet, tandis que « change the clothes » ou « replace the background » te donne le contrôle sur ce qui change vraiment.
Pour la conversion en anime, précise le look visé et verrouille l'identité : « crée une illustration anime 2D avec un trait net et un cel shading, conserve l'identité du visage, la coiffure, la pose et le cadrage, ne change que le style de rendu ».
Pour les restylages photoréalistes, ajoute des limites strictes sur le cadrage et l'arrière-plan. Le propre guide de prompting d'OpenAI recommande d'énoncer les exclusions explicitement, avec des formules comme « pas d'éléments supplémentaires », pour empêcher le modèle de dériver.
Pour le travail produit, le modèle publié par Google vaut la peine d'être repris quel que soit le modèle que tu utilises. Il précise la configuration d'éclairage, l'angle de caméra, la surface d'arrière-plan et le détail qui doit rester net.
Quand tu remplaces du texte ou un logo, mets-le entre guillemets. Le schéma FLUX Kontext documenté est : Replace "[texte original]" with "[nouveau texte]".
Corriger le résultat sans tout recommencer
La première génération est rarement la dernière. Tout recommencer gaspille des crédits quand une seule zone pose problème. Sur OpenArt, les corrections courantes restent sur le même canevas.
- Modifications par région. Le mode Area Edit d'Edit Image te laisse surligner un endroit précis et ne modifier que cette zone.
- Remplissage et suppression. Le remplissage génératif par IA comble un vide, supprime un objet ou étend le cadre.
- Changements de plan. Expand Image élargit le canevas à n'importe quel format ou preset social.
- Arrière-plans. Le suppresseur d'arrière-plan IA offre un détourage net, et le changeur d'arrière-plan IA remplace la scène.
- Visages. L'éditeur de visage IA gère les changements d'expression et les retouches.
- Upscaling. Le agrandisseur d'image fonctionne en mode Precise, Refined ou Creative, et le Vellum Skin Enhancer monte jusqu'à 8K quand la texture de la peau compte.
Chacune de ces corrections s'effectue sur le même canvas, avec le modèle utilisé pour la génération. Sur Midjourney, l'édition par région se fait sur Discord après un upscale, avec une version plus ancienne du modèle.
Usage commercial, droits d'auteur et propriété
Commence par la base. Le rapport de janvier 2025 du U.S. Copyright Office indique que le résultat d'une IA peut être protégé « uniquement lorsqu'un auteur humain a déterminé suffisamment d'éléments expressifs ». Cela couvre trois cas. Ton propre travail est visible dans le résultat, ou tu arranges le résultat de façon créative, ou tu le modifies de façon créative. Les prompts seuls ne comptent pas.
Concrètement, une image purement générée par prompt n'a pas de droit d'auteur, et ce sont tes propres retouches et ta composition qui lui en confèrent un.
Les conditions de la plateforme s'ajoutent par-dessus, et elles varient beaucoup. OpenArt ne revendique aucune propriété ni droit d'auteur sur tes créations. Les droits commerciaux s'appliquent sur les forfaits payants éligibles, sans redevances ni mention obligatoire. Les conditions grand public et pro d'OpenAI t'attribuent les droits sur les créations, tant que tu détenais les droits sur tes éléments d'entrée et que tu as respecté les règles d'usage. Midjourney exige un forfait Pro ou Mega avant qu'une entreprise dépassant 1 M$ de revenus annuels, ou l'un de ses employés, possède ses actifs.
Deux risques concernent spécifiquement le travail avec image de référence.
Importer une photo protégée sur laquelle tu n'as pas de droits peut poser problème en soi, quel que soit le rendu. Et publier une création qui finit par ressembler nettement à une œuvre protégée expose à une plainte, même sans intention.
Le Vérification de sécurité IP analyse ton rendu avant publication, à la recherche de similitudes avec des marques, de visages célèbres et de risques de ressemblance. Un résultat vert signifie que rien n'a été détecté, un avertissement signifie que quelqu'un devrait y jeter un œil, et « non sûr » signale une ressemblance significative. OpenArt précise que les résultats sont informatifs, alors considère un résultat vert comme un filtrage plutôt qu'une validation juridique.
Forfaits et crédits
OpenArt fonctionne avec un pool de crédits unique couvrant ses modèles d'image, de vidéo et d'audio. Tu peux commencer gratuitement avec 40 crédits sur 7 jours, sans carte, plus une allocation quotidienne de crédits gratuits pour la génération d'images basique ensuite.
| Plan | Mensuel | Crédits par mois |
|---|---|---|
| Starter | $14 | 4,000 |
| Plus | $34 | 12,000 |
| Pro | $56 | 24,000 |
| Wonder | $240 | 106,000 |
Ces montants correspondent à la facturation mensuelle. La facturation annuelle réduit chaque forfait, jusqu'à 27 % d'économie, et tous les forfaits payants exportent sans filigrane. Les crédits de base se réinitialisent chaque mois, et le pack Extra Credit à 15 $ ajoute environ 5 000 crédits qui, eux, sont reportés.
Kit de marque vaut le coup d'être configuré si tu génères pour une marque. Il enregistre ton logo, tes codes hex exacts, tes polices, tes visuels produit, tes références de style et tes règles de marque au niveau du projet, pour qu'un lot de références soit cohérent quel que soit le modèle choisi.
Pour commencer
Le moyen le plus rapide de juger l'image-vers-image, c'est d'y passer ta propre référence.
- Ouvre le générateur d'images OpenArt et importe ta photo de référence.
- Écris un prompt décrivant l'image finale, et précise ce qui doit rester identique.
- Choisis un modèle, règle le curseur de créativité et génère.
- Compare les variations, puis corrige ce qui est presque bon avec Area Edit ou l'upscaler.
- Si le même personnage doit réapparaître plus tard, crée-le une fois dans Personnages et tague-le dans tes futurs prompts.
FAQ
Quels formats et tailles de fichiers puis-je importer comme référence ?
La plupart des plateformes acceptent les formats web courants avec leurs propres limites de taille. Midjourney accepte les .png, .gif, .webp, .jpg et .jpeg jusqu'à 10 Mo. Quel que soit l'outil, une référence nette et bien éclairée, proche de ta résolution cible, donne le meilleur résultat, car le modèle ne peut pas récupérer un détail que ta référence n'a jamais eu.
Comment contrôler la fidélité du résultat par rapport à ma référence ?
Ça dépend de l'outil. Sur les outils Stable Diffusion, baisse le curseur d'intensité. Sur Midjourney, augmente-le --iw vers 3. FLUX Kontext et GPT Image 2 n'ont pas de curseur. Intègre plutôt la préservation dans le prompt, comme dans « en conservant les mêmes traits du visage et la même coiffure ». Sur OpenArt, le curseur de créativité s'en charge, et tu peux générer jusqu'à 8 variations à différents réglages pour voir l'éventail.
Puis-je utiliser des photos de vraies personnes comme références ?
Uniquement avec leur consentement. Les règles d'utilisation d'OpenAI interdisent d'utiliser l'image d'une personne sans son consentement, y compris une image ou une voix photoréalistes, d'une manière qui pourrait semer la confusion sur ce qui est réel. New York demande désormais aux annonceurs de le divulguer clairement lorsqu'ils utilisent sciemment un acteur synthétique dans une publicité. L'amende est de 1 000 $ pour une première infraction et de 5 000 $ pour chacune des suivantes. Pour tout usage commercial d'une personne réelle, obtiens les droits de tous les intervenants, le photographe comme le mannequin.
Quel modèle est le meilleur pour l'image-à-image ?
Ça dépend de la tâche. FLUX Kontext excelle sur les retouches locales et la préservation des personnages selon le benchmark de son créateur. GPT Image 2 gère les instructions multi-images complexes et les petits textes. Nano Banana Pro domine sur le rendu photoréaliste et accepte le plus de références, et Seedream est le choix pour l'anime et l'illustration. Les classements changent selon les tâches, alors passe ta référence dans GPT Image 2, Nano Banana Pro et Seedream sur OpenArt et compare, puisque ces trois-là puisent dans les mêmes crédits.
Pourquoi le logo de mon produit sort-il déformé ?
Parce que le modèle reconstruit le logo au lieu de le copier. Les tests de Photoroom ont révélé que la distorsion des logos et des textes était l'erreur de précision la plus courante. La solution est d'arrêter de demander ça au prompt : génère la scène, puis utilise Area Edit pour réparer uniquement cette zone, et vérifie à l'œil avant toute publication.
Comment éviter que le visage d'un personnage dérive d'une génération à l'autre ?
Arrête de réimporter une référence et enregistre plutôt ton personnage. Crée-le une seule fois dans OpenArt Characters à partir d'un prompt, d'une photo ou d'un préréglage. Puis tague ce personnage dans chacune de tes générations. Le modèle repart toujours du même point au lieu de reconstruire le visage depuis une nouvelle référence.
Puis-je transformer le résultat en vidéo ?
Oui. Une fois que tu as un visuel qui te plaît, l'Image vers Vidéo l'anime. OpenArt Director va plus loin et crée une vidéo multi-scènes qui garde les mêmes personnages d'un plan à l'autre. Générer le visuel d'abord puis l'animer ensuite te donne plus de contrôle que de décrire toute la vidéo en un seul prompt.