 ChatGPT
 Perplexity
 Claude
 Gemini
哪款 AI 图像模型能把人脸和手画对?我们查了评分
OpenArt Arena 的图像榜单上有七款图像模型,而在人物题材上如何抉择,通常只能靠猜。我们提取了已公布的各项评分,包括汇总排名里隐藏掉的那些,并将它们与每款模型的实际成本和运行速度一一对照。
- 人物题材首选:Seedream 5.0 Pro。 以 1,051 分领跑综合榜、1,074 分领跑影视榜,并以 1,037 分保持参考一致性榜首——正是这一点让同一张脸在不同镜头间保持可辨识。
- 最逼真:Nano Banana Pro。 在影视榜的写实度标准上得分 1,184,是七款中公布的最高分。
- 修复糟糕手部的最佳选择:GPT Image 2。 以 1,045 分领跑图像编辑,每张 $0.057 是最便宜的,并支持 16 张参考图。
七款模型对比
Arena 采用盲测一对一投票,并给出 Elo 式评分。Grok Imagine 2.0 固定为 1,000 作为基准锚点,因此下面每个数字都可解读为优于或劣于 Grok。评分仅在同一列内可比。
| 模型 | 总榜 | 电影 | 真实感 | 编辑 | 参考一致性 | 价格 | 适合 |
|---|---|---|---|---|---|---|---|
| Seedream 5.0 Pro | 1,051 | 1,074 | 1,142 | 1,037 | 1,037 | $0.09 | 人物题材首选 |
| GPT Image 2 | 1,047 | 1,058 | 1,058 | 1,045 | 1,035 | $0.057 | 修复手部或面部 |
| Nano Banana Pro | 1,008 | 1,059 | 1,184 | 1,035 | 1,002 | $0.134 | 最逼真的皮肤质感 |
| Grok Imagine 2.0 | 1,000 | 1,000 | 1,000 | 1,000 | 1,000 | $0.06 | 基准锚点 |
| Nano Banana 2 | 985 | 998 | 1,064 | 1,032 | 991 | $0.101 | 快速 4K 草稿 |
| Qwen Image 3.0 | 966 | 964 | 975 | 992 | 973 | $0.075 | 风格多样性 |
| Flux.2 Pro | 927 | 978 | 1,022 | 955 | 881 | $0.08 | 身份一致性最弱 |
来源:OpenArt 的 Arena 排行榜,图像榜,v1.0。
关于这些评分涵盖和不涵盖什么,再说一点,然后我们继续。Arena 评的是真实感、身份一致性和编辑精度。它不做单独的解剖结构测试,所以这里没有任何指标帮你数手指。真实感是最接近的已公布替代指标,而 Nano Banana Pro 的 1,184 与 Qwen Image 3.0 的 975 之间的差距,大到足以派上用场。置信区间重叠的模型可视为打平。
哪些模型最适合人物题材
Seedream 5.0 Pro
最稳妥的默认选择。它领跑综合榜和影视榜,以 1,103 分拿下创意最高分,而 1,037 分的参考一致性意味着你喂给它的脸往往会返回成同一个人。它还支持透明背景,这一点仅有 GPT Image 2 能匹敌。
不足之处在于速度和上限。它最高支持 2K,可接收 10 张参考图,生成一张 1K 图像需 88.9 秒。它在平面设计上还降到了 975 分,所以如果你的图像需要干净的排版,请在这里生成人物、到别处再排文字。完整规格见 Seedream 5.0 Pro 模型页面.
GPT Image 2
修复利器。它在图像编辑上以 1,045 分领先,同时也悄然在 Prompt 遵循度上以 1,041 分领跑——当你要精确指定哪只手拿什么东西时,这一点尤为重要。它可输出 4K,支持 16 张参考图,接受 32,000 字符的 prompt,运行时间为 44.8 秒。
相较榜首,它的弱点在于美感:主观美感得分 1,030,落后于 Seedream 的 1,043;写实度 1,058,落后于 Nano Banana Pro 的 1,184。在别处生成,来这里修复。这款 GPT Image 2 模型页面 列出了各种编辑模式。
Nano Banana Pro
真实感的领跑者,优势明显。真实感得分 1,184,电影感 1,059,支持 4K、14 张参考图,速度快至 39.9 秒。
有两点拖了后腿。每张 $0.134,是七款中最贵的,约为 GPT Image 2 的 2.4 倍。而在主观美学上得分 981,平面设计上 952,两项均低于基准线,因此它更常给人技术上以假乱真的感觉,而非美感十足。
Nano Banana 2
草稿模型。Google 将其记录为 Gemini 3.1 Flash Image。18.1 秒、4K、14 张参考图,是在投入更慢的模型前找到满意构图的最快方式。真实感稳定在 1,064,综合为 985,所以把它的输出当作草图看待。规格和示例见 Nano Banana 2 模型页面.
人物题材应避开哪些模型
Flux.2 Pro 参考一致性得分为 881,是七款中最低的,因此不适合用于角色类工作。 Qwen Image 3.0 prompt 一致性得分为 915,因此像“仅左手握住把手”这样的特定姿势更容易生成错误,而它以 99.1 秒成为榜上最慢的模型。 Grok Imagine 2.0 是基准线,作为参考点很有用,且价格便宜,每张 $0.06,但并非推荐之选。
参考遵循度对角色一致性意味着什么
参考遵循度是表格里最不直观的数字。Arena 让七款模型跑同一个任务:一名男子在三张街头抓拍中,分别行走、倚墙和过马路,三张图里保持同样的面孔、发型和着装。
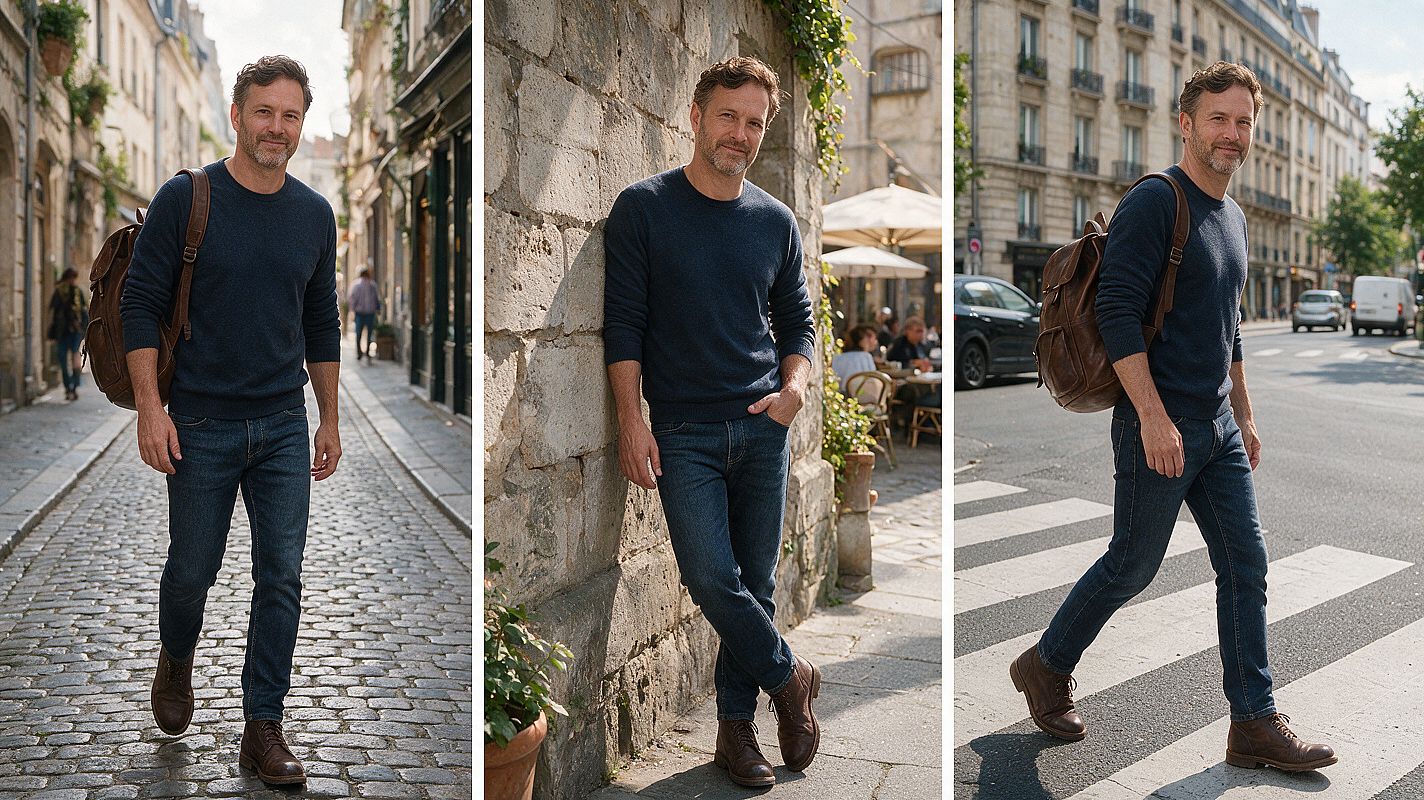
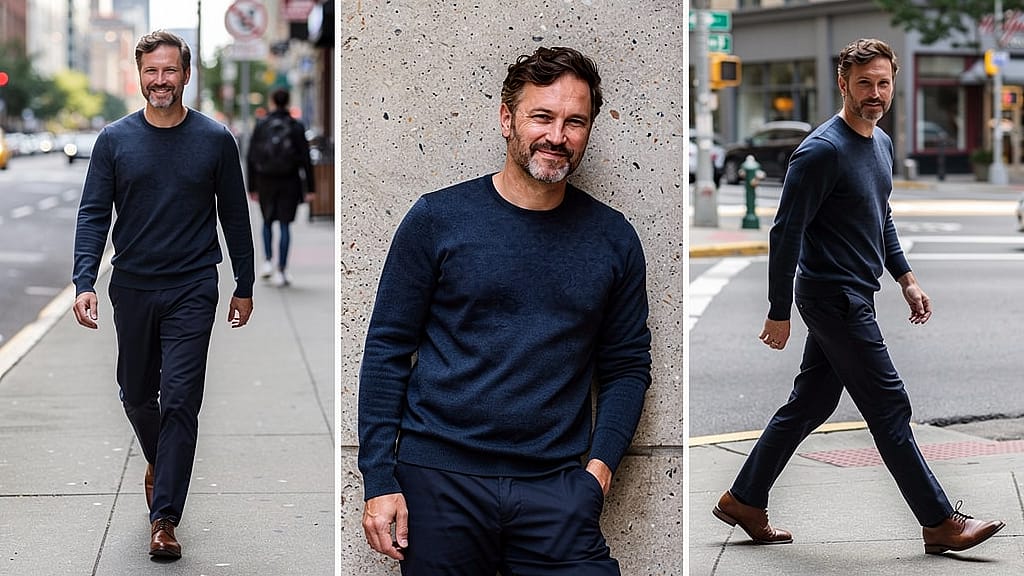
Arena 拿这些图去比对一张它不公开的参考图,所以分数就是裁决,而非你的肉眼判断。你能看到的,是任务要求在这趟过程中有多少得以保留。七款的输出都在 Arena 排行榜 在参考一致性一栏下,如果你的作品涉及固定角色、品牌代言人或 AI 虚拟人物,那么这一列比综合排名更重要。
为何到 2026 年 AI 仍会把手画错
一只手有十六个可独立活动的关节,而在大多数镜头里,其中好几个都被彼此或被物体遮挡。模型必须从可能只占几百个像素的区域,去推断它看不见的解剖结构。
Research from March 2025 put numbers on it. A team including researchers at Peking University built a 500 prompt human benchmark and found that close to half of generated images contained some distortion. Their companion dataset, Distortion-5K, annotated 4,700 images, and most flawed regions took up only a small share of the frame, which is why defects survive a quick glance. That study tested an older generation of models, so read it as evidence that the problem is real and hard to spot, not as a ranking of the seven models here.
从那以后变化的是瑕疵出现的位置。居中的肖像或摊开的手掌现在通常都没问题。错误转移到了更难的地方:手指环握杯柄、两人牵手、手靠近脸、透视缩短的手臂,以及站在主体身后的那些小脸。
如何测试 AI 图像模型的面部与手部表现
分数缩小了选择范围,最终由你自己的 prompt 定夺。整个过程约需两小时。
来设置它。 从表格中挑选三个模型,在 AI 图片生成器,七款模型都从同一个 prompt 输入框加载。给每款相同的 prompt、参考图、宽高比和分辨率。每个 prompt 生成四张图。只在服务出错时重试,绝不能因为你不喜欢某个结果而重试,否则你评的是自己的耐心,而不是模型。
用会让模型出错的 prompt 来测试。 六款覆盖了大部分场景:
- 抓握物体把手的手
- 两个人手牵手
- 一只手抬到脸部附近
- 一个用左手完成的动作
- 一条透视缩短、朝镜头伸出的手臂
- 五人一组,背景中露出面孔
增加一项身份一致性测试:在全部三个模型中使用同一张参考图。
盲评打分。 隐藏模型名称。把每张图都以全分辨率打开,因为在信息流里看不出的瑕疵,放大到 100% 就一目了然。看手时,检查手指数量、间隔、拇指位置、手腕连贯性、关节方向,以及抓握是否真正触及物体。看脸时,检查视线、牙齿、耳朵、侧脸轮廓和无意的不对称。数清每一个可见的人,包括后方的小人物。
每个模型给出两个数字: 首次输出的通过率,以及全部四次的通过率。四次里只对一次的模型,实际带来的工作量比其平均值所显示的要多。
如何在不改变画面的前提下修复 AI 生成的手和脸
说明画面中出现几只手,以及每只手在做什么。“一只可见的左手握着咖啡杯把手”比“一个拿着咖啡的人”能给模型提供多得多的信息。第一次生成时保持简单。交叉的手臂、交叠的手指、三件道具加四个人挤在一条 prompt 里,正是画面崩坏的地方。
按你在意的解剖部位来构图。占 40 像素的脸,就只有 40 像素的细节可供处理,无论你选哪款模型。如果背景里的人脸很重要,就把画面裁得更紧,或者提高分辨率。
当某处出现问题时,只对缺陷区域进行遮罩,并要求做一处具体的修正。较小的遮罩能让模型更少地重绘人物。然后在全分辨率下将修复结果与原图对比,重点看边界处:袖口、首饰、阴影和接触点,正是局部编辑悄然失去局部性的地方。
如何为你的工作挑选合适的模型
Arena 会随着新模型上线重跑这些对比,所以你今天据以规划的排名,未必下个季度还成立。Seedream 5.0 Pro 和 GPT Image 2 在综合得分上仅差四分,近到一次发布就足以让它们互换位次。
在为人物题材统一选定一款模型之前,先看看这里最关键的四个榜单的当前数据:综合、电影感、图像编辑,以及电影感项下的真实感指标。新账号可获 40 个免费积分,无需信用卡,足够你在三款模型上跑完六项 prompt 测试。
常见问题
哪个模型最适合逼真的面部?
Nano Banana Pro 在 Arena 的写实度标准上以 1,184 分排名最高,领先 Seedream 5.0 Pro 的 1,142 分。若需要同一张脸在多张图像间保持一致,Seedream 是更好的选择,因为它还以 1,037 分领跑参考一致性榜。
哪款模型最擅长画手?
没有任何榜单单独为手部打分。Seedream 5.0 Pro 和 Nano Banana Pro 在最接近的真实感和电影感指标上领先,而 GPT Image 2 是事后修复手部的最强选择。在定下来之前,先用上面的六项 prompt 测试跑一遍你自己的任务。
目前的模型还会多画手指吗?
会,不过在简单姿势上已经少多了。如今的失误主要集中在手持物体、交叉手指、遮挡和背景中的小手。2025 年一项针对更早一代模型的研究发现,其 500 条 prompt 的人物基准测试中,近半数存在畸变。
如何在不改变面部的前提下修复 AI 生成的手?
只遮罩手部以及它接触物体的区域,然后请求一处具体修正,例如让拇指位置更自然。在这类任务上,GPT Image 2 以 1,045 分领跑 Arena 的图像编辑榜。修完后请检查编辑边界,看看袖子、阴影和首饰有没有被改动。
做这类工作哪款模型最便宜?
GPT Image 2 每张 $0.057,其次是 Grok Imagine 2.0 的 $0.06 和 Qwen Image 3.0 的 $0.075。Nano Banana Pro 最贵,每张 $0.134。
哪个模型最快?
Nano Banana 2 为 18.1 秒,Grok Imagine 2.0 为 18.3 秒。Qwen Image 3.0 最慢,为 99.1 秒,Seedream 5.0 Pro 紧随其后,为 88.9 秒。
参考图能解决身份漂移问题吗?
它们能减轻这个问题。相似角度的清晰参考图能为模型提供面部比例和独特特征的依据。但在不同姿势和编辑中身份仍可能发生变化,因此请对比各输出之间的发际线、皮肤纹理和比例,而不是想当然地认为参考图会被保留。
综合得分高就代表解剖结构更好吗?
单看它并不够。综合分是四大类标准等权重的平均值。人物题材请参考写实度和参考一致性,修复类工作请参考编辑能力。