 ChatGPT
 Perplexity
 Claude
 Gemini
一句话总结
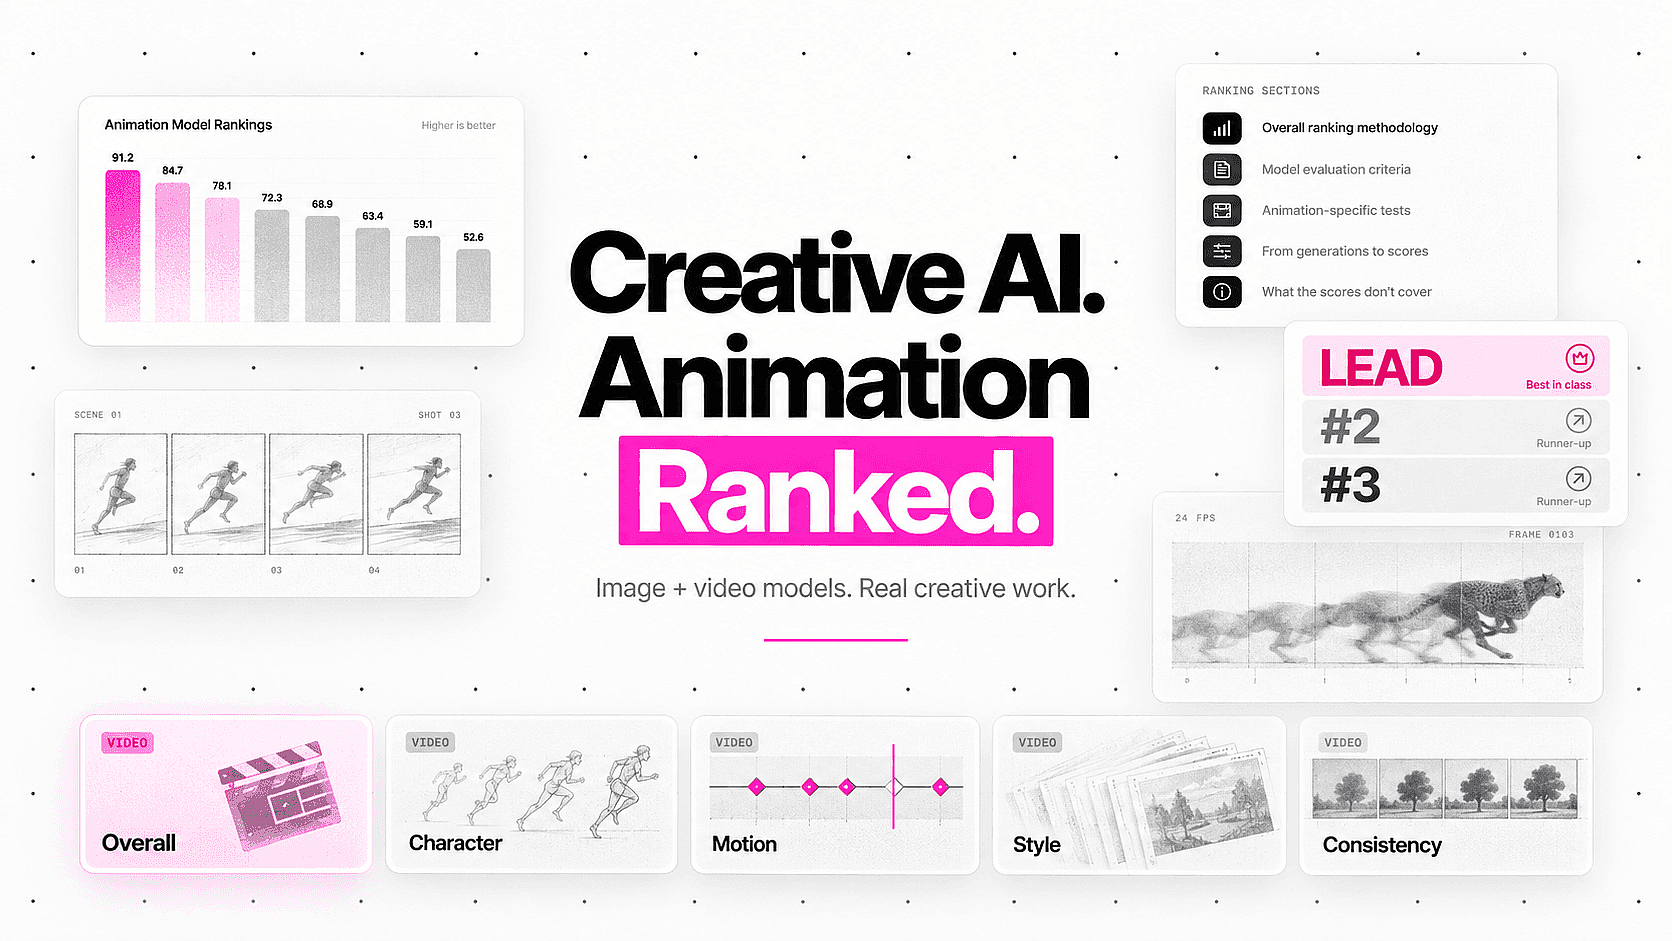
Seedance 2.5 领跑 OpenArt Arena 动画榜单 得分 1,077,领先于 Seedance 2.0 的 1,054 和 Wan 3.0 的 1,039。
Arena 为每个得分公布 95% 置信区间,四项动画标准的区间约为正负 55 分。 前四名模型在每项标准上的置信区间都存在重叠,但重叠程度各不相同。 Seedance 2.0 的角色一致性得分最高,为 1,063,但其区间 1,005 至 1,119 与 Seedance 2.5 的区间 985 至 1,101 重叠。因此已公布的区间并不能证明 Seedance 2.0 在该项标准上表现更好。
这些标准区间将部分领先模型与得分较低的模型区分得更为清晰。Seedance 2.0 的角色一致性区间与 Google Omni Flash、HappyHorse 1.1 或 Flux 3 Video 完全没有重叠。
用综合得分筛选出候选名单,再查看相关标准得分,并用你自己的参考素材和制作 prompt 测试入围模型。
11 款模型的动画排名情况
Arena 在动画综合得分中将通用能力权重设为 30%,角色一致性、动作质量、镜头连贯性和风格理解各占 17.5%。榜单为每个模型汇报约 5,250 至 5,320 票。Arena 将 MiniMax H3 固定为基准值 1,000。高于或低于 1,000 的得分表示该模型相对于该基准的估计表现。
括号内表示 95% 置信区间;加粗数值代表每列中最高的点估计值。
| 排名 | 模型 | 综合得分(95% 置信区间) | 角色一致性 | 运动质量 | 镜头连贯性 | 风格理解 |
|---|---|---|---|---|---|---|
| 1 | Seedance 2.5 | 1,077 (1,058–1,098) | 1,045 (985–1,101) | 1,084 (1,035–1,134) | 1,091 (1,028–1,145) | 1,007 (956–1,066) |
| 2 | Seedance 2.0 | 1,054 (1,035–1,074) | 1,063 (1,005–1,119) | 1,029 (982–1,074) | 1,085 (1,028–1,141) | 1,057 (1,007–1,107) |
| 3 | Wan 3.0 | 1,039 (1,020–1,059) | 997 (939–1,055) | 1,052 (994–1,104) | 1,057 (1,000–1,113) | 1,037 (984–1,091) |
| 4 | Seedance 2.0 Mini | 1,021 (1,002–1,042) | 967 (907–1,023) | 1,078 (1,030–1,126) | 1,026 (963–1,089) | 994 (945–1,041) |
| 5 | MiniMax H3(基准) | 1,000 | 1,000 | 1,000 | 1,000 | 1,000 |
| 6 | Google Omni Flash | 999 (979–1,019) | 934 (879–985) | 1,024 (969–1,080) | 990 (929–1,045) | 997 (946–1,049) |
| 7 | Flux 3 Video | 970 (951–989) | 946 (892–990) | 1,004 (957–1,051) | 959 (908–1,012) | 913 (853–976) |
| 8 | Grok Imagine 1.5 | 953 (933–975) | 967 (902–1,027) | 953 (900–1,003) | 947 (881–1,011) | 926 (871–984) |
| 9 | HappyHorse 1.1 | 947 (927–966) | 905 (842–965) | 943 (887–993) | 950 (886–1,014) | 938 (898–980) |
| 10 | PixVerse V6 | 920 (899–942) | 905 (836–971) | 911 (860–956) | 895 (836–951) | 912 (848–978) |
| 11 | Kling 3.0 Omni | 918 (896–941) | 935 (869–995) | 887 (821–952) | 888 (825–941) | 859 (810–909) |
置信区间显示了点估计值周围存在多少不确定性,因此仅凭排名顺序并不能支撑每一项模型间的结论。
为何置信区间比排名顺序更重要
本榜单上的综合得分区间约为正负 20 分,而各项标准得分区间约为正负 55 分,因为每项标准仅基于部分投票拟合,而非全部投票。较宽的标准区间使得模型之间的细微差异更难以定论。
综合结果比标准结果更清晰地区分了排名中的若干部分。Seedance 2.5 的区间为 1,058 至 1,098,与 Wan 3.0 的 1,020 至 1,059 仅有一分的重叠。不过,整个前四并未与 Google Omni Flash 拉开明确距离,因为 Seedance 2.0 Mini 的区间 1,002 至 1,042 与 Google Omni Flash 的 979 至 1,019 存在重叠。
各项标准的区间并未明显区分出前四名模型。
- 角色一致性。 Seedance 2.0 的区间 1,005 至 1,119 与 Seedance 2.5 的区间 985 至 1,101 在大部分范围内重叠。已公布的区间并不能证明这 18 分的差距反映了更好的表现。
- 动作质量。 Seedance 2.5 的区间 1,035 至 1,134 与 Seedance 2.0 Mini 的区间 1,030 至 1,126 几乎完全重叠。这些各自的置信区间并不能直接检验两款模型之间的差异。
- 镜头连贯性。 Seedance 2.5 的区间 1,028 至 1,145 与 Seedance 2.0 的区间 1,028 至 1,141 几乎完全相同。仅凭这些各自的区间无法在该项标准上确定明确的优胜者。
- 风格理解。 Seedance 2.0 的区间为 1,007 至 1,107,与 Wan 3.0 的 984 至 1,091 重叠。Seedance 2.5 的区间为 956 至 1,066,也与两者均有重叠。
竞技场的置信区间显示了每个估计值周围的不确定程度。读者可借此避免把微小的分差当作定论,不过要判断两款模型是否存在显著差异,仍需进行直接的两两对比测试。
各项标准得分差距较大之处
角色一致性区间为降低某些低分模型的优先级提供了更有力的证据,而非用于在领先者之间做出选择。
Seedance 2.0 的角色一致性区间起始于 1,005,而 Google Omni Flash 上限为 985,Flux 3 Video 为 990,HappyHorse 1.1 为 965。这些不重叠的区间比领先者之间的微小差距提供了更有力的差异证据。它们支持在重复出现角色的测试中降低这些模型的优先级,但并不能衡量制作工作流的每一项要求。
Kling 3.0 Omni 综合排名垫底,为 918 分,风格理解方面也排在末位,为 859 分,其区间始终未达到 910。它的动作质量最高为 952,低于 Seedance 2.5 的下限 1,035。
相比在区间大量重叠的模型中挑出优胜者,榜单更能自信地缩小候选范围。最终选择应通过成片测试,结合你自己的参考图、prompt、镜头类型和验收标准来决定。
如何分开解读角色一致性与动作质量
Arena 分别汇报角色一致性和动作质量,因为一段片段可能保留了身份却产生了不连贯的动作,或动作连贯却改变了角色。
角色一致性衡量的是在榜单以角色为核心的任务中,输出保留参考角色的效果如何。Arena 不会为脸部、服装、比例或身体结构分别公布得分。动作质量评估的是身体、物体和环境在时间上是否连贯地运动。一个模型可能在静态对话画面中完美保持人脸,却在奔跑动作中让同一角色的手臂变形。
你的成片测试应区分片段内的身份保持与不同生成之间的一致性。竞技场的镜头连贯性标准评估的是其公布任务内的连贯性,但榜单并不能证明某款模型能在独立生成的多个场景中保持同一个反复出现的角色。
参考图约束旨在帮助在多次生成之间保持身份一致,但其效果因模型和工作流而异。请用同一张已确认的参考图测试每个入围者,因为竞技场排名并不衡量你特定的跨场景成片配置。
Arena 公布了与标准结果相关联的示例片段。角色一致性 prompt 要求围绕一张提供的参考人脸生成一段 10 秒竖版马戏场景,全部十一次尝试并排展示在同一行—— 动画榜单.
如何借助本榜单选择动画模型
分三轮来看,而不是顺着排名列往下读。
第一轮:根据综合分建立候选名单。 Seedance 2.5、Seedance 2.0、Wan 3.0 和 Seedance 2.0 Mini 占据点估计值最高的前四位。Seedance 2.0 Mini 的区间与 Google Omni Flash 重叠,因此已公布的区间无法支撑第四名与第六名之间存在清晰界限。
第二轮。对比最重要的那项标准。 对于以角色为主的项目,角色一致性结果针对 Google Omni Flash、Flux 3 Video、HappyHorse 1.1 和 PixVerse V6 提供的证据比针对领先模型更为有力。对于动作密集的项目,Kling 3.0 Omni、PixVerse V6 和 HappyHorse 1.1 的动作质量估计值明显低于领先者。请将这些结果视为优先安排测试的理由,而非普遍适用的排除依据。
第三轮。对比榜单未评分的因素。 在相关模型页面上查看当前价格、片段时长、分辨率、音频设置和生成模式,然后进行受控的参考测试。OpenArt 提供以下模型的最新详情: Seedance 2.5, Seedance 2.0 与 Seedance 2.0 Mini,以及 Wan 3.0。请对比配置相当的方案,因为 Arena 不对成本或制作限制进行评分。
对于短小、动作密集的镜头序列,Seedance 2.0 Mini 值得与 Seedance 2.5 直接对比测试。它的动作质量得分为 1,078,而 Seedance 2.5 为 1,084,两者置信区间大幅重叠。这些区间并不能证明两者动作质量相当。请在打算用于成片的镜头上同时测试两款模型。
如何进行榜单无法替你完成的测试
选出两三名入围者,为每一款提供相同的角色参考、相同的 prompt 措辞、相同的宽高比和相同的时长。
生成一个短序列,而非单段片段。跨越一次场景切换,包含一个特写镜头和一个动作镜头,然后以更高的动作强度重复该动作。每个镜头都使用同一张经核准的参考图,并保持固定不变。
分别审查身份与动作。对比每个镜头中脸部、服装等身份线索。然后单独检查身体结构、接触点、背景和物体互动。一张可辨认的脸可能掩盖了错乱的身体结构或不连贯的环境。Arena 不会公布身体结构、脸部或手部得分,所以这一轮由你来做。
要评判整个序列,而不是其中最好的一个片段。统计每个可用镜头花了多少次生成,再用总花费除以你真正会发布的片段数。重试率可能使定价更低的模型在每个可用镜头上反而更贵,因此请记录生成成本以及在相同输出配置下所需的尝试次数。
对这些得分的产生方式尚不熟悉的读者,可在此处了解评判流程、锚定模型以及投票权重的说明 OpenArt Arena 是什么.
常见问题
在 OpenArt 竞技场动画类别中排名第一的 AI 视频模型是哪款?
Seedance 2.5,综合得分 1,077,95% 置信区间为 1,058 至 1,098。其后是 Seedance 2.0(1,054)和 Wan 3.0(1,039)。
哪个模型的角色一致性最好?
Seedance 2.0 的角色一致性得分最高,为 1,063。其置信区间与 Seedance 2.5 大幅重叠,因此仅凭各自的区间无法确立明确的胜者。
OpenArt Arena 是否公布单独的角色一致性得分?
是的。角色一致性是一项明确的动画评判标准,占综合分的 17.5%,与动作质量、镜头连贯性和风格理解权重相同。通用能力占其余的 30%。
为何标准得分的确定性不如综合得分?
每项标准仅基于部分投票拟合,而非全部,因此其区间更宽。在本榜单上,综合得分区间约为正负 20 分,标准得分约为正负 55 分。Arena 将两者都予以公布,这正是使区别显而易见的原因。
动画排名高是否意味着面部或手部表现更好?
不是。竞技场不发布任何解剖结构、面部或手部得分。角色一致性反映的是榜单以角色为核心的任务中身份保持程度。竞技场不会针对面部、手部或解剖结构发布单独的准确度得分。
价格应如何影响选择?
请在每款模型页面查看相同分辨率、时长、音频和生成设置下的当前定价。竞技场评估的是质量而非成本,因此在完成受控的成片测试后,比较每个可用镜头的总花费。
参考图像有多重要?
参考图片可能影响身份保留效果,但影响程度因模型和工作流而异。请为每个入围模型使用同一张经核准的参考图,让对比衡量的是模型表现,而非源素材的差异。
在哪里能看到这些得分背后的片段?
这份 动画榜单 公布了每项标准的示例生成结果,包括角色一致性 prompt——该 prompt 将同一张提供的参考人脸分别输入全部十一个模型运行。