 ChatGPT
 Perplexity
 Claude
 Gemini
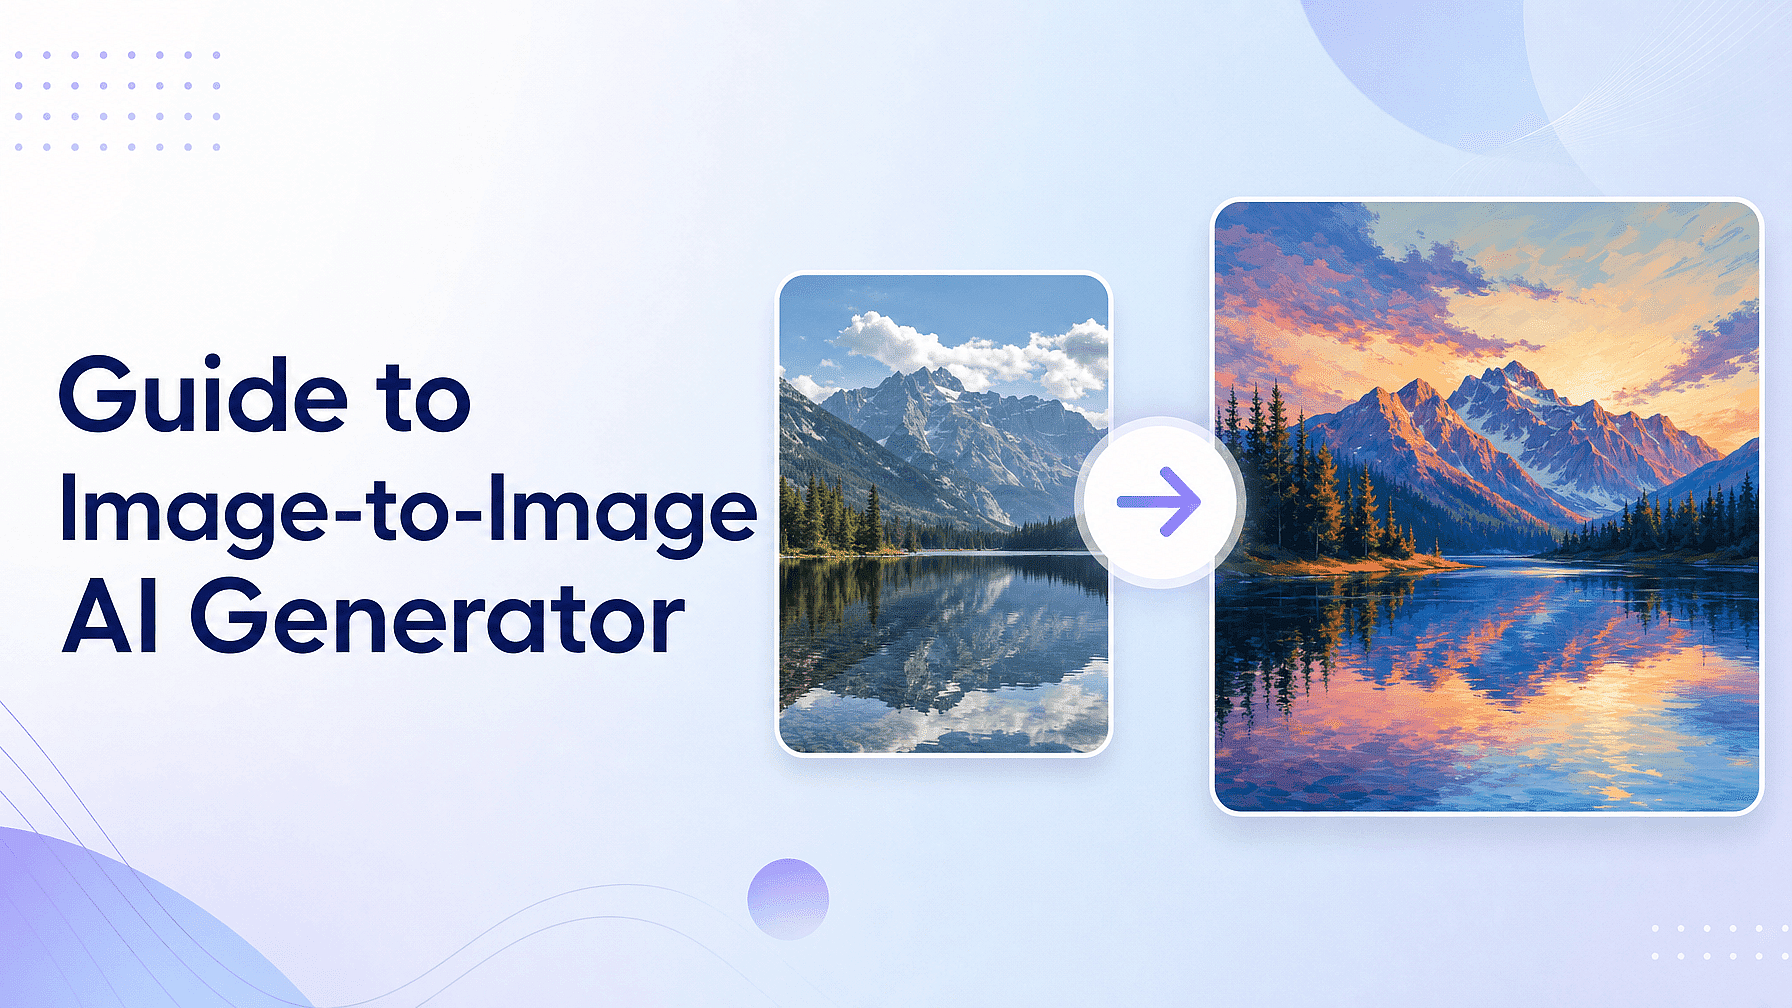
上传一张照片,添加 prompt,模型就会构建一张新图像,在改变你所要求内容的同时,保留参考图的构图、姿态、光照或风格。
这就是图生图生成,它解决了文本 prompt 无法解决的问题。仅凭文本无法匹配已经存在的事物,无论是你的产品、你的角色、你的排版,还是你多年打磨出来的某种风格。
要点总结
- 图生图会从参考图中读取结构和风格,而不是复制它的像素。构图和姿势能可靠地保留下来,细节则不然。
- 精确的 logo 和小号文字是弱项,因此请打算使用蒙版编辑并进行人工核查,而非指望一段 prompt 搞定。
- 不同模型各有擅长的任务,这正是把一张参考图跑两三个模型胜过押注单一模型的原因。
- 较新的编辑器取消了保真度滑块,因此现在需要在 prompt 里明确写出保留要求。
- 上传你并不拥有权利的参考图本身就是一种风险,与输出最终呈现的样子无关。
什么是图生图 AI 图像生成器?
基于图像的 AI 图像生成器,通常称为 图生图 或 img2img,它接受两个输入而非一个:一张参考图和一段文本 prompt。模型会从参考图中读取色彩、结构、光影和姿态,而不是直接复制像素。然后再根据你的 prompt 生成一张全新的图像。
如果你只用过文生图,两者的差别在掌控力上立刻显现。文字 prompt 可以描述“一位穿红色夹克、四分之三侧面的女性”,却无法重现某个特定的女性、特定的夹克或特定的相机角度。
参考图可以做到。在 OpenArt 上,你可以在填写 prompt 的同时上传照片,输出便会保留你的构图,而风格、氛围或细节随之改变。
图生图与文生图
两种方式都基于相同的底层模型,只是解决的问题不同。
| 尺寸 | 图生图 | 文生图 |
|---|---|---|
| 输入 | 参考图加文本 prompt | 仅文本 prompt |
| 掌控力 | 高,因为构图和姿态锚定在参考图上 | 较低,因为模型是根据你的描述来构建的 |
| 一致性 | 在多次生成中保持相同的主体或布局 | 每次生成都从零开始 |
| 适合 | 产品拍摄、风格迁移、角色创作、照片重塑 | 概念构思、探索、全新场景 |
当你还在探索、不确定想要什么时,用文生图。当你手上已有素材——比如产品照片、角色设定图、草图或版式——需要生成忠于原图的版本时,就用图生图。
图生图 AI 的工作原理
扩散模型的处理方式是:先把你的参考图编码成压缩形式,加入可控量的噪点,再用你的 prompt 引导去噪。Hugging Face 官方文档说得很直白:强度值越高,模型就有越大的空间生成与参考图不同的内容。当强度为 1.0 时,参考图「基本会被忽略」。
模型会从你的参考图中提取结构和风格。它能可靠地传递构图、配色、光照方向、姿态和相机角度,但不能可靠传递的是精确的细节。
Photoroom 于 2026 年 7 月对 850 款服饰和配饰产品进行了 3400 次生成测试。表现最佳的模型仅在 29.0% 的生成中通过其产品准确性检查。最常见的失败是 logo 或文字失真,占 20.1%。Photoroom 售卖一项产品还原度服务,因此对这一结论有利益关系。
即使考虑到素材来源,这个教训依然成立。如果你的作品依赖于精确的标签或 logo,请规划好蒙版编辑和人工检查,而不是仅靠 prompt。
从参考图迁移风格
风格迁移之所以奏效,是因为模型会将参考图的画风与内容分开解读。Midjourney 的文档说得很好:风格参考"捕捉现有图像的视觉氛围",即它的色彩、媒介、纹理或光影,但"不会复制物体或人物"。
同样的思路适用于各类工具。参考图提供外观,prompt 提供主体。
要在一批图片中保持统一外观,请把它保存下来,而不是每次都重新上传。OpenArt 的 Brand Kit 会在项目层面存储你的配色、字体和风格参考,OpenArt Characters 则会存储一个人物,你可以在后续图片中标记他。
控制输出保真度
Stable Diffusion 工具带有强度或去噪滑块,可直接设定平衡。计算很简单:把强度乘以推理步数就是实际运行的步数,所以强度 0.8 搭配 50 步会运行 40 步的变化。
简单来说,数值越低,输出越贴近你上传的照片;越高则给模型更大的发挥自由。Stable Diffusion Art 的取值可作大致参考:0.2 左右为轻微改动,0.6 为大幅改动,1.0 为极大改动。网上看到的更精确数字,请当作别人测试出的默认值而非官方指引,自己摸索出适合的即可。
OpenArt 在图生图中通过创意滑块来处理这一点,从贴近原图的细微重塑,到只保留大致构图的大胆再创作,任你选择。
Midjourney 使用图像权重,写作 --iw。其文档列出的取值范围是 0 到 3,V8.1 默认值为 1,V8.2 尚未公布数值。
像 FLUX.1 Kontext 和 GPT Image 2 这样较新的指令式编辑器彻底取消了滑块。你通过在 prompt 中写入保留条款来控制保真度。
如何从参考图生成图片,分步详解
各个平台的流程大致相同。以下是在 OpenArt 上的做法。
- 在此处上传你的参考图 AI 图像生成器.
- 写你的 prompt。描述你想要的最终图片,而不是编辑参考图的指令。
- 选一个模型。GPT Image 2 擅长处理复杂指令和小字体,Nano Banana Pro 适合搭配多张参考图的写实创作,而 Seedream 4.5 是动漫和扁平插画的首选。
- 调整创意滑块。数值越低越贴近参考图,越高则给模型更多重新演绎的空间。
- 生成、对比多达 8 个变体,并下载你想要的那些。
速度取决于模型。FLUX.1 Kontext 生成一张 1024×1024 的图像需要三到五秒。根据 Replicate 的测算,Nano Banana 平均约为十秒。OpenAI 表示,复杂的 GPT Image 2 prompt 最长可能需要两分钟。
最适合图生图的 AI 模型
没有哪个模型能在所有任务上胜出,这正是把一张参考图跑几个模型的实际理由。在下列模型中,GPT Image 2、Nano Banana Pro 和 Seedream 共用 OpenArt 的积分池,所以比较这三者不必比较各自的订阅。FLUX、Stable Diffusion 和 Midjourney 则各需自己的账户。
- FLUX(Black Forest Labs)。 在 BFL 自家的 KontextBench 上,FLUX.1 Kontext 在文字编辑和角色保留方面得分最高。它是首个为多轮编辑打造、能在多次改动中保持身份一致的模型。BFL 坦承其局限,并记录了连续六次编辑后可见的画质退化。它现在会引导新项目使用 FLUX.2,后者通过 API 最多可接受 8 张参考图。
- GPT Image 2(OpenAI)。 每次编辑请求最多可接收 16 张输入图像,并以高还原度处理每一张输入。它在 Artificial Analysis 图像编辑排行榜上以 1256 Elo 位居第三。在学术基准 GEditBench v2 上,GPT Image 1.5 以 1260 分获得最高的指令遵循得分,而 Nano Banana Pro 拿下综合第一。
- Nano Banana Pro(Google)。 官方名称为 Gemini 3 Pro Image。Google 说明单个 prompt 最多支持 14 张参考输入,其中 6 张可为高还原度,并可对最多五人保持稳定的相似度。它原生输出 4K。
- Seedream(字节跳动)。 动漫、插画和海报排版的首选。Seedream 5.0 Pro 可融合多达 10 张参考图,而 Seedream 4.5 在 2D 动画风格上表现更强。
- Stable Diffusion。 若自行运行,它仍是掌控最精细的方案,配有强度滑块和 ControlNet 结构引导,不过官方 SD 3.5 ControlNet 仅涵盖 Canny、Depth 和 Blur,姿态或草图引导则来自社区。
- Midjourney(V8.2)。 通过图像 prompt 和风格参考实现出色的默认美学效果。它的 Omni Reference 功能仍运行在 V7 上,耗费两倍的 GPU 时间,且不支持 Vary Region、Pan、Zoom Out、Fast Mode 或 Draft Mode。它没有免费版,套餐起价为每月 10 美元。
Replicate 于 2025 年 9 月对上一代模型做过对比测试,发现 FLUX.1 Kontext 和 Nano Banana 在文字编辑中最能保留排版与质感,而 Nano Banana 和 Seedream 在风格迁移上胜过 Kontext。在批量生成花费积分之前,先用你自己的参考图测试一下。
热门用例
只要输出必须与已有的东西相匹配,图生图就能派上用场。
- 风格迁移。 为你已有的照片套用绘画风格、电影质感或品牌美学。
- 产品摄影。 把手机随手拍的照片变成放在新表面上的影棚打光成片,同时保持产品的形状不变。
- 动漫与艺术风格转换。 将人像转换为动漫、插画或漫画风格,同时保留身份和姿态。
- 角色一致性。 在数十次生成中保持同一张脸、同一套服装和相同比例。
- 融合参考图。 将多个输入融合成一个输出,Nano Banana Pro 最多可用 14 张,FLUX.2 最多 8 张。
- 图生视频。 用成品画面作为片段的首帧。
跨输出的角色一致性
身份漂移是参考图工作中最常见的失败模式。同一张脸每次生成都会略有不同,到第十张图时,角色已经悄悄变成了另一个人。
OpenArt 角色 通过把角色变成保存的资产而非每次 prompt 的参考图来应对漂移。用 prompt、参考照片或预设一次构建好角色,然后把同一角色标记到之后的任意图片或视频中,包括在此处的场景 OpenArt Director,多场景视频工具。
这一差异远比任何跑分数据都重要。用参考图,模型每次都得重新推导面部;而用已保存的角色,模型每次都从同一个起点出发。
图生图的 prompt 工程
如今每款编辑器都采用自然语言而非关键词标签。这套规则在 FLUX、GPT Image 和 Gemini 上通用:描述你想要的最终图像,而不是你想做的编辑。
明确说明必须保留什么,并选用精确的动词。Black Forest Labs 在其 prompt 指南中直接指出:「transform」意味着彻底改变,而「change the clothes」或「replace the background」则让你能掌控真正改变的内容。
转换为动漫风格时,请指明目标画风并锁定身份特征:"创作一张 2D 动漫插画,线条干净、赛璐璐上色,保留人物的面部身份、发型、姿势和构图,仅改变渲染风格。"
对于写实风格的重绘,请对取景和背景加上硬性限制。OpenAI 官方的 prompt 指南建议明确列出排除项,包括使用诸如“无额外元素”之类的措辞,以防止模型跑偏。
做产品创作时,Google 公布的模板值得借鉴,无论你用哪个模型。它会指明光照设置、拍摄角度、背景表面,以及必须保持清晰的细节。
当你要替换文字或标志时,请用引号把它引出来。FLUX Kontext 记录的写法是:Replace "[original text]" with "[new text]"。
无需重来即可修正结果
第一次生成往往不是最终结果。当只有一处出错时,重新开始会白白浪费积分。在 OpenArt 上,常见的修改都能在同一画布上完成。
- 区域编辑。 图像编辑的区域编辑模式让你只选中某一处,仅修改该区域。
- 填充与移除。 生成式 AI 填充可填补空隙、移除物体或扩展画面。
- 画面变化。 扩展图像可将画布拓宽至任意宽高比或社交平台预设尺寸。
- 背景。 AI 抠图工具能给出干净的剪影,AI 背景替换工具则能更换场景。
- 面部。 AI 面部编辑器可处理表情变化和修饰润色。
- 放大。 这份 图像放大工具 支持精确、精修或创意模式运行,当皮肤质感至关重要时,Vellum 皮肤增强器可将画质提升至 8K。
所有这些修复都在同一张画布上、用你生成时所用的模型完成。而在 Midjourney 上,局部编辑要先放大后在 Discord 上进行,使用的是较旧的模型版本。
商业用途、版权与所有权
先从基准说起。美国版权局 2025 年 1 月的报告指出,AI 成品"只有在人类作者确定了足够的表达元素时"才能受到保护。这涵盖三种情况:你自己的作品在成品中可见、你对成品进行了创意编排,或你对其进行了创意修改。仅凭 prompt 是不算数的。
实际上这意味着纯靠 prompt 生成的图像不受版权保护,而你自己的编辑与排布才是版权的来源。
平台条款则叠加于此之上,且差异很大。OpenArt 对你的输出不主张任何所有权或版权。符合条件的付费套餐享有商用权,无需支付版税,也无需署名。OpenAI 的消费者与企业条款将输出权利归于你,前提是你对输入拥有权利并遵守了使用政策。Midjourney 则要求年营收超过 100 万美元的公司(或其员工)先购买 Pro 或 Mega 套餐,才能拥有其生成的资产。
参考图工作有两大特有的风险。
上传一张你并不拥有权利的受版权保护照片,无论输出结果如何,本身就可能引发问题。而发布的输出若最终与受保护作品高度相似,即便无人有意为之,也可能招致侵权主张。
这份 IP 安全检查 会在你发布前对输出进行筛查,检测品牌相似度、名人面孔和肖像风险。绿色结果表示未检测到任何问题,警告表示需要有人查看,不安全则表示存在明显的相似性。OpenArt 声明结果仅供参考,因此请把绿色结果视为初筛,而非法律许可。
套餐与积分
OpenArt 运行在一个统一的积分池上,涵盖其图像、视频和音频模型。你可以免费开始,7 天内享有 40 积分且无需绑卡,之后基础图像生成还有每日免费积分额度。
| 套餐 | 每月 | 每月积分 |
|---|---|---|
| 入门版 | $14 | 4,000 |
| Plus | $34 | 12,000 |
| Pro | $56 | 24,000 |
| Wonder | $240 | 106,000 |
这些价格为按月计费。按年计费可让每个套餐降价,最多省 27%,且所有付费套餐导出时均无水印。基础积分每月重置,15 美元的额外积分包约提供 5000 积分,且可以结转。
品牌套件 如果你为某个品牌做生成,值得设置一番。它会在项目层级保存你的标志、精确的十六进制色值、字体、产品素材、风格参考图和品牌规则,这样无论你选择哪个模型,一批参考图都能保持一致。
快速上手
判断图生图效果最快的方法,就是拿你自己的参考图跑一遍。
- 打开 OpenArt 图像生成器并上传你的参考照片。
- 写一段描述最终图像的 prompt,并说明哪些部分必须保持不变。
- 选择模型,设置创意滑块,即可生成。
- 对比各种变体,然后用区域编辑或超分工具修复接近理想的那一张。
- 如果同一个角色之后还需再次出现,只需在 Characters 中构建一次,并在未来的 prompt 中标记它。
常见问题
我可以上传哪些文件格式和尺寸作为参考图?
大多数平台都支持常见的网页格式,并各有尺寸上限。Midjourney 接受 .png、.gif、.webp、.jpg 和 .jpeg,最大 10 MB。无论用哪款工具,一张清晰、光线充足、分辨率接近目标的参考图效果最好,因为模型无法还原参考图中原本就没有的细节。
我该如何控制输出与参考图的贴近程度?
这取决于工具。在 Stable Diffusion 工具上,调低强度滑块;在 Midjourney 上,调高 --iw 趋近 3。FLUX Kontext 和 GPT Image 2 没有滑块,请改在 prompt 中写入需保留的内容,例如“同时保持相同的面部特征和发型”。在 OpenArt 上,创意滑块即可实现,你还能在不同设置下生成多达 8 个变体来查看差异范围。
我可以用真人照片作为参考图吗?
只有在获得当事人同意时才可以。OpenAI 的使用政策禁止在未经同意的情况下使用他人肖像(包括写实图像或声音),尤其是那些可能让人分不清真假的方式。纽约州现要求广告商在明知使用合成表演者时须清晰披露。首次违规罚款 1,000 美元,此后每次 5,000 美元。任何涉及真实人物的商业用途,都要从所有相关方获得授权,包括摄影师和模特。
哪个模型最适合图生图?
这取决于任务。在其开发者的基准上,FLUX Kontext 在局部编辑和角色保留方面领先。GPT Image 2 擅长处理复杂的多图指令和小号文字。Nano Banana Pro 在写实作品上领先,且能接收最多的参考图,而 Seedream 是动漫和插画的首选。不同任务的排名会变动,因此不妨把你的参考图放到 OpenArt 上的 GPT Image 2、Nano Banana Pro 和 Seedream 里跑一遍再对比——这三者共用同一套积分。
为什么我产品的 logo 生成出来是错的?
因为模型是重建 logo 而非复制它。Photoroom 的测试发现,logo 和文字变形是最常见的准确度失败。解决办法是不要让 prompt 去做这件事:先生成场景,再用局部编辑单独修复该区域,并在交付前用肉眼检查。
如何避免角色的面部在多次生成之间发生变化?
别再反复上传参考图,把角色保存起来吧。在 OpenArt Characters 中用 prompt、照片或预设一次构建好,然后在之后的每次生成中标记该角色。这样模型每次都从同一起点开始,而不是从新的参考图重新推导面孔。
我能把结果转成视频吗?
可以。一旦你有了满意的静态图,Image to Video 就能让它动起来。OpenArt Director 更进一步,能构建一段跨镜头保持相同角色的多场景视频。先生成静态图再让它动起来,比用一个 prompt 描述整段视频能给你更多控制。